 Web Designer
 Redes Sociais
 IA para Negócios
 Conteúdo Criativo
 Tecnologia da Informação
 Singles e Jingles
Resumo Em 31 de outubro de 2026, o desenvolvedor Ryan Madden publicou o relato de um experimento direto e fácil de entender. Ele colocou o GPT-5.6 Sol, da OpenAI, para jogar Factorio dentro do Codex, com nível baixo de raciocínio, e o modelo completou uma partida no modo pacífico, sem inimigos, em 13,5 horas de tempo de jogo, terminando com o lançamento do foguete. O ponto central não é que uma inteligência artificial jogou um jogo. O ponto central é que ela sustentou um projeto longo, com muitas etapas dependentes umas das outras, por horas, e chegou ao objetivo mesmo depois de falhar em conectar partes da fábrica no fim da partida. O custo estimado, cerca de US$ 52, e o volume de tokens, cerca de 250 milhões de entrada, mostram que o feito ainda é caro e pesado para uma tarefa de jogo, e que o resultado depende de condições bem específicas, que precisam ser lidas junto com o número final.
Contexto: o que é Factorio e por que um jogo virou teste de agente Factorio é um jogo de construção e automação. O jogador começa quase do zero, extrai matérias primas, funde metais, pesquisa tecnologias e monta linhas de produção cada vez mais complexas, até construir e lançar um foguete para o espaço. Lançar o foguete é a forma de vencer a partida, e fazer isso bem exige planejar dezenas de linhas interligadas ao mesmo tempo, controlar fluxo de materiais, evitar gargalos e corrigir erros antes que eles parem a fábrica inteira. Por isso o jogo virou um teste interessante para agentes de inteligência artificial. Um teste de conversa pode ser resolvido em segundos, com uma resposta certa ou errada. Uma fábrica precisa continuar funcionando. Se o planejamento falha, a produção trava. Se uma esteira não conecta, um recurso não chega. Se uma pesquisa atrasa, a próxima etapa não abre. O resultado aparece na tela, em forma de fábrica funcionando ou parada, o que torna o comportamento do modelo muito mais legível para quem não é especialista. O próprio Madden usa essa ideia. Para ele, jogar Factorio é parecido com programar, com a vantagem de ser muito mais fácil de observar. O experimento também chega em um momento em que a discussão sobre agentes mudou de pergunta. A pergunta já não é só se o modelo responde bem a uma pergunta isolada. A pergunta passou a ser se ele consegue manter um objetivo por horas, lembrar o que já fez, priorizar o que falta e se recuperar de erros sem que um humano precise intervir a cada passo. Factorio não responde a essa pergunta sozinho, mas oferece um cenário concreto para observá-la.
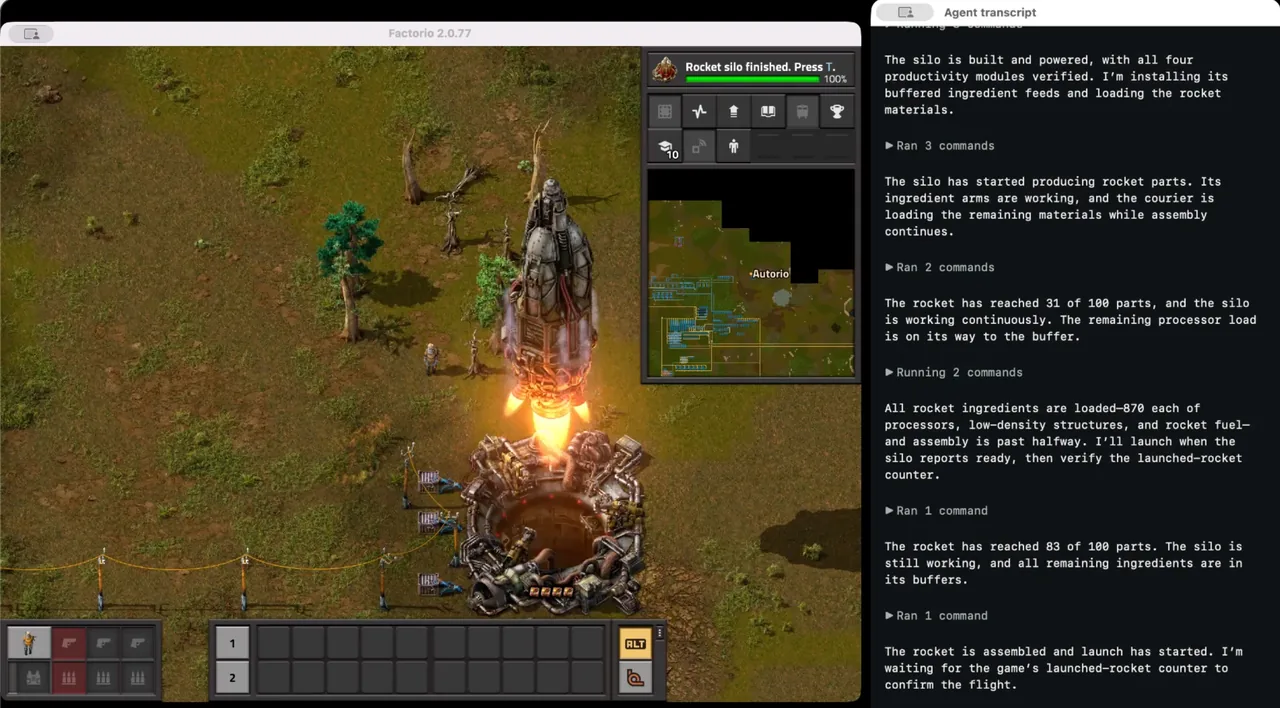
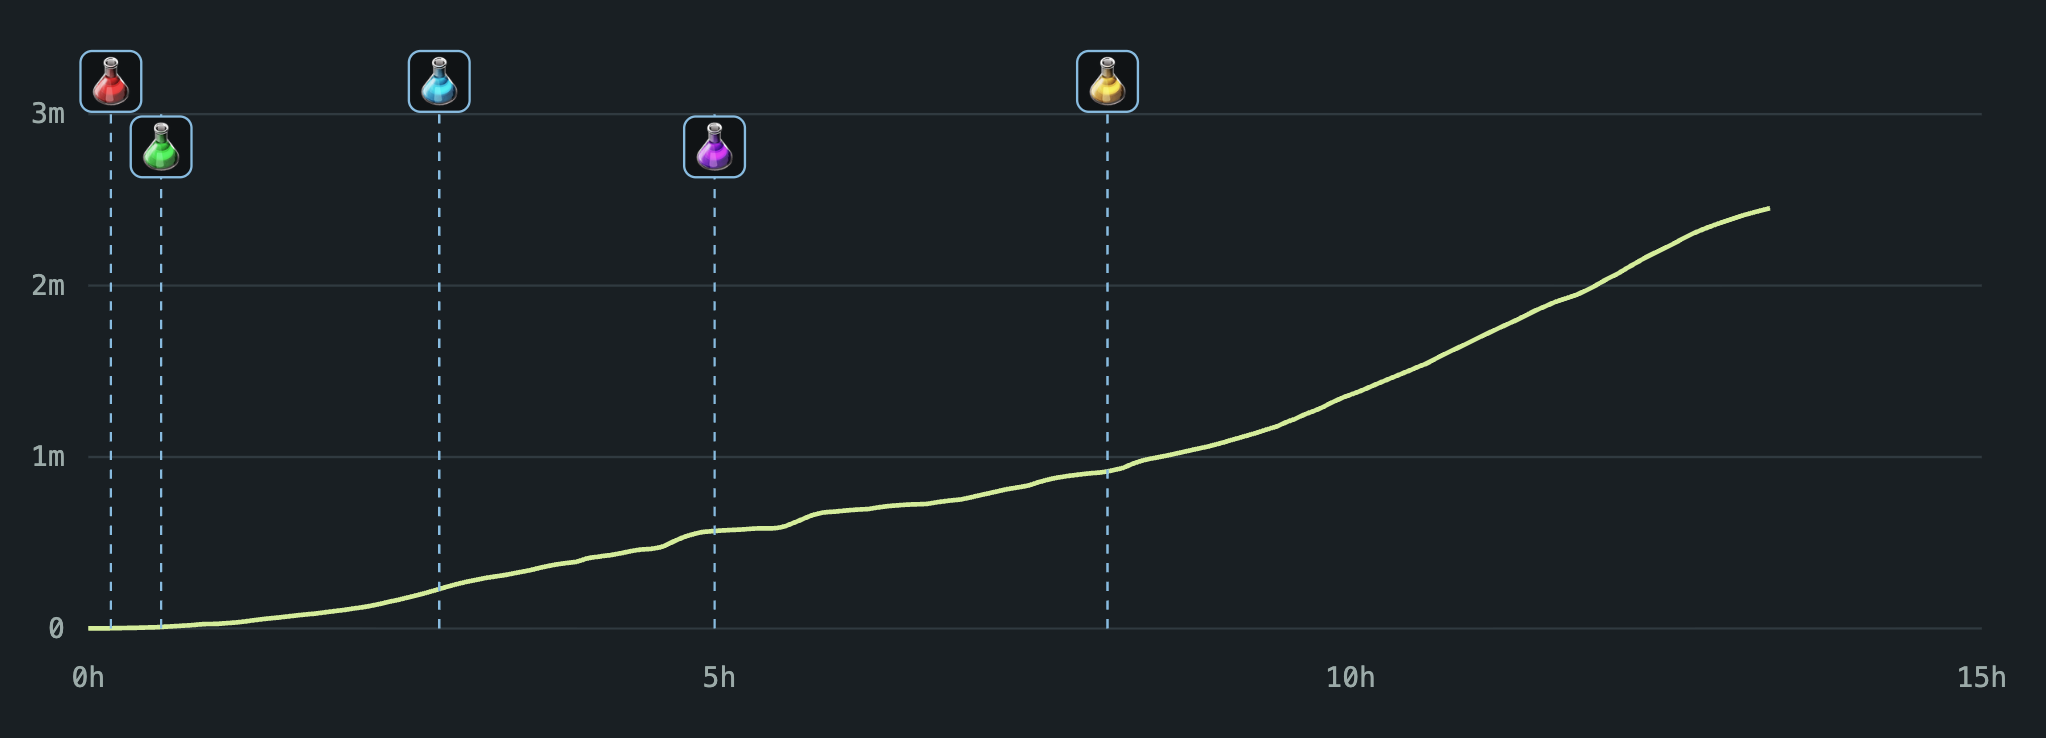
O feito, passo a passo O relato de Madden é curto e direto. Ele usou o GPT-5.6 Sol dentro do Codex, com nível baixo de raciocínio, e um gerenciador de jogo em Python para permitir que o modelo interagisse com o jogo de forma programática. A biblioteca usada respeitava as mesmas restrições que um jogador humano enfrenta ao usar a interface do jogo, como alcance do personagem e nevoeiro de guerra. Ou seja, o modelo só podia agir sobre o que o personagem podia ver e tocar, e não tinha uma visão completa e irrestrita do mapa. No início, o plano era encerrar a partida depois da pesquisa de ciência azul, uma etapa intermediária importante. O desempenho inicial convenceu Madden a continuar. O modelo montou a extração de recursos, organizou a produção, usou esteiras transportadoras e avançou pelas pesquisas científicas, até chegar à construção e ao lançamento do foguete. O gráfico de produção capturado pelo gerenciador mostra a produção total subindo ao longo da partida, com marcos de pesquisa anotados, o que ajuda a ver onde o progresso acelerou e onde ele travou. O detalhe que mais chama atenção no relato é que o foguete não veio de uma fábrica perfeita. No fim da partida, problemas de escala apareceram e o modelo falhou em conectar corretamente alguns sistemas de produção. Em vez de corrigir as conexões, ele contornou o problema transportando suprimentos manualmente, várias vezes, entre áreas desconectadas da fábrica, até que o foguete ficasse pronto. O resultado final foi alcançado, mas o caminho revela uma fragilidade importante, que será tratada mais adiante. Madden também registra o contraste com a geração anterior. Em tentativas anteriores com o GPT-5.5, o modelo falhava em usar esteiras transportadoras. Nesta partida, o Sol construiu esteiras e organizou fábricas. A melhora é real, mas ela não deve ser lida como prova de perfeição. Ela mostra progresso em uma habilidade específica, dentro de um cenário específico, e não uma capacidade geral sem falhas.
Os números, com leitura crítica Tempo de jogo: 13,5 horas. Esse é o tempo dentro do jogo, não o tempo de relógio de uma pessoa jogando sem parar, e não deve ser comparado diretamente com o tempo de um jogador humano experiente sem explicar as condições. O modelo jogou em modo pacífico, sem inimigos, e com nível baixo de raciocínio, o que torna o feito mais impressionante em um sentido, porque ele usou menos esforço de raciocínio por decisão, e mais limitado em outro, porque o cenário eliminou uma fonte inteira de pressão, que é a defesa da fábrica. Tokens: cerca de 250 milhões de tokens de entrada, com 95% em cache, e 1,5 milhão de tokens de saída, segundo Madden em mensagem à RuntimeWire. O cache é decisivo para entender o custo. Sem ele, o mesmo volume de entrada custaria muito mais. Com 95% em cache, grande parte do contexto já processado foi reaproveitada a um custo menor, o que reduz bastante a conta final. Custo estimado: cerca de US$ 52, a preços de API, segundo o mesmo relato. Esse número não é um preço de produto para o usuário final, e não é o custo de um jogador humano, que paga pelo jogo e pelo seu tempo. É uma referência de custo de inferência para uma tarefa longa, com um modelo de ponta, em condições controladas. Para uma partida de jogo, US$ 52 é alto. Para um teste de capacidade de agente, é um número útil, porque mostra que tarefas longas ainda consomem muito contexto e muito processamento, mesmo quando o modelo está em nível baixo de raciocínio. Progresso em relação ao GPT-5.5: de não usar esteiras para construir e organizar fábricas. Esse é um salto qualitativo, não apenas um número maior em um ranking. Em testes de agente, a diferença entre não conseguir executar uma ação básica e conseguir organizá-la em escala é mais relevante do que uma pequena variação de pontuação. O que os números não dizem: eles não dizem quanto tempo real de computação foi necessário fora do tempo de jogo, não dizem quantas intervenções humanas indiretas existiram na montagem do gerenciador e na decisão de continuar depois da ciência azul, e não dizem como o mesmo modelo se sairia com inimigos ativos, com nível de raciocínio diferente ou com outro mapa. O próprio autor deixa essas perguntas em aberto, ao prometer testar outros modelos, outros níveis de raciocínio e partidas não pacíficas.
Como o modelo jogou, e onde ele falhou O comportamento do Sol na partida pode ser resumido em três fases. Na primeira, ele foi eficaz. Montou a base, organizou a produção inicial e avançou nas pesquisas com um layout que convenceu o autor a continuar. Na segunda, ele sustentou o progresso, com produção crescente e marcos de pesquisa sendo alcançados. Na terceira, a escala cobrou o preço. Quando os sistemas precisaram se conectar em um nível maior, as conexões falharam, e o modelo não corrigiu a causa do problema. Ele improvisou, transportando materiais manualmente entre áreas desconectadas, até completar o objetivo. Esse improviso é ao mesmo tempo um sinal de robustez e um sinal de limite. É robustez porque o modelo não travou diante do erro. Ele encontrou um caminho alternativo e persistiu até o objetivo. É limite porque o caminho alternativo é ineficiente e frágil. Em uma fábrica real, ou em um sistema de software real, contornar um problema de conexão com trabalho manual repetido pode funcionar uma vez, mas não escala, e esconde o defeito em vez de resolvê-lo. Se o objetivo fosse apenas lançar o foguete, o improviso bastou. Se o objetivo fosse construir uma fábrica bem projetada, reutilizável e fácil de manter, o resultado seria bem menos impressionante. Outro ponto importante é o papel do gerenciador em Python. O modelo não jogou apertando botões na tela como um humano. Ele agiu por meio de uma biblioteca que traduzia suas decisões em ações no jogo, dentro de restrições humanas de alcance e visão. Isso não invalida o experimento, porque as restrições foram pensadas para manter a comparação honesta, mas impede dizer que o modelo jogou exatamente como uma pessoa joga. Ele jogou em um ambiente preparado para agentes, o que é o cenário mais relevante para o uso real de agentes, e não para uma competição de habilidade humana.
Por que isso importa fora do jogo O interesse do experimento vai além do jogo porque as habilidades testadas são parecidas com as exigidas de agentes em trabalho real. Um agente que precisa migrar um sistema, organizar um projeto, montar um relatório a partir de muitas fontes ou operar uma ferramenta por horas precisa planejar em longo prazo, lembrar decisões anteriores, controlar o fluxo de tarefas e se recuperar de erros sem perder o objetivo. Factorio torna essas habilidades visíveis. Quando a fábrica para, todo mundo vê. Quando a produção volta, todo mundo vê também. Para pequenas empresas e profissionais que acompanham o site, a lição prática não é comprar um modelo para jogar. A lição é entender o estágio atual dos agentes. Eles já conseguem sustentar tarefas longas e improvisar diante de falhas, mas ainda falham em conectar sistemas em escala, ainda dependem de muito contexto e ainda custam caro em tarefas longas. Isso sugere um uso prudente. Agentes podem ajudar em tarefas supervisionadas, com checkpoints, revisão humana e métricas claras de progresso, mas ainda não devem ser tratados como trabalhadores autônomos confiáveis para projetos longos sem supervisão. O experimento também ajuda a separar marketing de capacidade. Um vídeo de um foguete lançando é fácil de compartilhar e fácil de interpretar como prova de inteligência geral. O relato completo, com falhas de escala e improviso manual, é mais útil, porque mostra onde o modelo é forte, onde ele é fraco e quanto custa chegar ao resultado. Para quem cria conteúdo sobre tecnologia, essa é a diferença entre um post viral vazio e uma resenha que o leitor entende de verdade.
Limitações, riscos e o que não provar Primeiro, modo pacífico. Sem inimigos, a fábrica não precisa se defender, não sofre ataques e não precisa dividir atenção entre produção e proteção. Uma partida com inimigos testaria planejamento sob pressão, priorização em crise e recuperação depois de danos, e o resultado poderia ser bem diferente. Segundo, nível baixo de raciocínio. O autor usou essa configuração de propósito, e o resultado é mais notável por isso, mas também não mostra o que o modelo faria com mais esforço de raciocínio, nem se mais raciocínio resolveria os problemas de conexão no fim da partida ou apenas aumentaria o custo. Terceiro, ambiente preparado. O gerenciador em Python, a biblioteca de ações e as restrições humanas tornam o teste mais justo, mas também o afastam de uma partida humana comum. O modelo não precisou ler a tela, mover o mouse ou lidar com a interface gráfica como uma pessoa. Ele operou por meio de uma interface programática, que é o cenário esperado para agentes, mas que deve ser declarado sempre que o feito for apresentado. Quarto, uma única partida, com um único mapa e uma única configuração. Não há, neste relato, uma amostra estatística de partidas, nem comparação controlada com outros modelos nas mesmas condições. O autor promete esses testes, mas eles ainda não existem. Até lá, o resultado deve ser tratado como um estudo de caso, não como um ranking definitivo. Quinto, acesso restrito à família GPT-5.6. Segundo relatos do lançamento, a família foi apresentada em preview restrito a partir de 29 de outubro de 2026, com acesso inicial a parceiros aprovados, e não como um produto aberto para todos. Isso significa que o leitor comum não pode simplesmente repetir o experimento hoje nas mesmas condições, com o mesmo modelo e o mesmo preço. O feito é verificável pelo relato e pelo vídeo do autor, mas não é facilmente reproduzível pelo público neste momento. Sexto, custo e contexto. Cerca de 250 milhões de tokens de entrada, mesmo com 95% em cache, mostram que tarefas longas exigem janelas de contexto enormes e gestão cuidadosa de custo. Em uso real, isso se traduz em conta de API, latência e necessidade de resumir, arquivar e recuperar contexto, e não apenas em inteligência do modelo. Por fim, risco de leitura exagerada. O fato de um modelo lançar um foguete em um jogo não prova que ele entende fábricas reais, que ele pode operar infraestrutura crítica ou que ele substitui engenheiros, programadores ou gerentes de projeto. Prova que, em um ambiente simulado, legível e com objetivo claro, ele consegue sustentar um plano longo, com falhas visíveis, até o objetivo. Essa é uma conclusão forte o suficiente, sem precisar exagerá-la.
O que observar a seguir O autor prometeu três desdobramentos que valem acompanhamento. Primeiro, um vídeo com comentários e destaques da partida completa, que pode mostrar com mais detalhe onde o modelo acertou e onde ele improvisou. Segundo, testes com outros modelos, para saber se o resultado é específico do Sol ou um avanço mais geral da geração atual. Terceiro, testes com outros níveis de raciocínio e com partidas não pacíficas, que são os testes que mais podem mudar a leitura do feito, para melhor ou para pior. Além disso, vale observar a ampliação do acesso à família GPT-5.6, os preços após o período de preview e a chegada de novos benchmarks de agentes de longa duração. Se outros laboratórios publicarem partidas de Factorio nas mesmas condições, com o mesmo tipo de gerenciador e as mesmas restrições, a comparação ficará mais justa. Se cada laboratório publicar apenas o seu melhor caso, sem as falhas, o público deve desconfiar da comparação. Para o leitor que quer acompanhar o tema sem cair em hype, a pergunta certa para os próximos testes é simples. O modelo apenas chegou ao objetivo, ou ele chegou ao objetivo com um sistema bem conectado, eficiente e fácil de entender? No experimento do Sol, a resposta foi a primeira opção. Nos próximos, a segunda opção é o verdadeiro avanço a procurar.
Glossário Agente: sistema de inteligência artificial que planeja e executa tarefas em várias etapas, usando ferramentas, sem supervisão constante, e que precisa lidar com erros ao longo do caminho. Codex: ambiente da OpenAI para tarefas de programação e agentes, usado neste experimento para rodar o modelo e conectá-lo ao jogo. Token: unidade de texto contada para cobrança e para medir o uso de um modelo. Tokens de entrada são o texto enviado ao modelo, e tokens de saída são o texto gerado por ele. Cache de tokens: reaproveitamento de contexto já processado, que reduz o custo de tokens de entrada repetidos em conversas ou tarefas longas. Nível de raciocínio: configuração que controla quanto esforço de raciocínio interno o modelo usa antes de responder ou agir. Nível baixo significa menos esforço por decisão. Modo pacífico: modo de Factorio sem inimigos, em que a fábrica não sofre ataques e o jogador pode focar apenas em produção e pesquisa. Ciência azul: etapa intermediária de pesquisa em Factorio, usada pelo autor como ponto inicial para decidir se a partida continuaria. Nevoeiro de guerra: limite de visão no jogo, em que o jogador só enxerga as áreas já exploradas ou próximas ao personagem, e não o mapa inteiro. Foguete: objetivo final da partida de Factorio, cuja construção e lançamento marcam a vitória no jogo.
Galeria