 Web Designer
 Redes Sociais
 IA para Negócios
 Conteúdo Criativo
 Tecnologia da Informação
 Singles e Jingles
- LiberAI
- Liber-0
- robôs
- zero-shot
Introdução
Ensinar um robô a fazer uma tarefa nova costuma ser um trabalho manual e caro. Alguém precisa demonstrar a tarefa com o próprio robô, várias vezes, até que a máquina aprenda os movimentos certos. Se a tarefa muda um pouco, se o objeto muda de lugar ou se o copo é outro, o aprendizado pode não se transferir, e o processo começa de novo. A LiberAI, uma startup de inteligência artificial física, apresentou em 3 de novembro de 2026 uma tentativa de quebrar esse gargalo, com o Liber-0, um modelo que ela chama de World Action Model, ou modelo de ação do mundo, treinado com mais de 2,2 milhões de horas de experiência humana.
O número que virou manchete foi 36%. Em uma avaliação com 60 tarefas de manipulação que o modelo nunca tinha treinado com demonstrações de robô específicas para aquelas tarefas, o Liber-0 acertou 36% das tentativas. À primeira vista, 36% pode parecer pouco, e é importante dizer isso com clareza: na maioria das tentativas, o robô falhou. Mas no contexto da robótica, onde cada tarefa nova costumava exigir demonstrações próprias, o fato de um modelo acertar mais de um terço de tarefas inéditas, sem treino específico para elas, é um sinal de que algo está mudando na forma de ensinar máquinas a mexer no mundo físico.
O Liber-0 ainda é pesquisa, não produto. Não há um robô doméstico à venda com esse modelo, nem uma data de lançamento para o consumidor. O que a LiberAI apresentou é um modelo e uma avaliação, com números da própria empresa, ainda sem verificação independente. Esta notícia explica o que foi anunciado, como o modelo foi treinado, o que o teste das 60 tarefas realmente mede e, sobretudo, o que os 36% não provam.
O que foi anunciado
O Liber-0 é descrito pela LiberAI como um World Action Model, um modelo que aprende relações entre o que o robô vê, a ação física que ele executa e o que acontece no mundo depois dessa ação. A ideia é parecida, em espírito, com a dos grandes modelos de linguagem, que aprendem com enormes quantidades de texto humano em vez de serem programados com uma resposta para cada pergunta. No caso do Liber-0, o material de aprendizado é a experiência humana com o mundo físico: vídeos de pessoas fazendo coisas, movimentos de mãos registrados com luvas instrumentadas e demonstrações feitas com robôs.
A empresa diz que o modelo foi pré-treinado com mais de 2,2 milhões de horas de experiência humana. É preciso entender esse número com cuidado. Ele não significa que milhões de horas foram gastas demonstrando tarefas, uma por uma, para robôs. Grande parte dessa experiência é vídeo de atividade humana em larga escala, que dá ao modelo uma exposição ampla a pessoas, objetos, ambientes e interações físicas. O material mais detalhado, que conecta o que se vê com o movimento físico exato, vem de demonstrações humanas capturadas com luvas e de demonstrações feitas com robôs. O objetivo é transformar assistir em fazer, ou seja, converter a observação de uma ação humana em uma ação que um robô consegue executar.
A LiberAI foi fundada em dezembro de 2025, segundo a cobertura especializada, e tem como ambição declarada levar robôs de uso geral para a vida cotidiana. É uma ambição grande, e o Liber-0 é apresentado como um passo nessa direção, não como a chegada. A empresa também desenvolveu uma simulação interativa, na qual, após 100 horas de teleoperação simulada no pós-treinamento, o usuário pode introduzir os seus próprios objetos e ver o Liber-0 tentar manipulá-los no ambiente virtual, sem treino específico para aqueles objetos. Para tarefas mais longas e complicadas, a LiberAI diz que o Liber-0 pode trabalhar junto com um agente de nível mais alto, que quebra um objetivo maior em metas intermediárias, enquanto o Liber-0 traduz essas metas em sequências de ações físicas, com novas observações servindo de retorno ao longo do caminho.
Como o modelo tenta aprender com humanos
O problema central que o Liber-0 tenta resolver é a transferência da experiência humana para o robô, e a LiberAI identifica três desafios. O primeiro é visual: as gravações humanas e as câmeras do robô podem ver a mesma atividade de pontos de vista muito diferentes. O segundo é o que a empresa chama de lacuna de supervisão de ação: as posições e trajetórias das mãos inferidas de um vídeo comum podem ser incompletas ou imprecisas, por causa de oclusões, erros de estimativa de profundidade e outras limitações. O terceiro é a lacuna de incorporação: humanos e robôs têm corpos diferentes, e uma mão, um pulso e um braço humanos podem realizar uma ação com movimentos que um robô específico não consegue reproduzir de forma idêntica.
Para enfrentar esses desafios, a LiberAI combina vários tipos de material de treino. Vídeos humanos em larga escala dão ao modelo uma experiência visual ampla. Demonstrações de robôs dão exemplos de ações que máquinas conseguem executar fisicamente. Entre os dois está um dos elementos mais interessantes da pesquisa: demonstrações humanas registradas com luvas instrumentadas. A luva da LiberAI, chamada LiberSense Glove, registra poses e trajetórias das mãos enquanto a pessoa manipula objetos, e uma câmera em primeira pessoa e duas câmeras nos pulsos registram a atividade ao mesmo tempo. Isso dá ao sistema uma informação muito mais rica do que o vídeo comum, porque associa o que está acontecendo visualmente com medidas de como as mãos realmente se movem.
Outra vantagem prática da luva é que coletar dados de manipulação humana não exige a presença de um robô. Em vez de precisar de um robô e de um operador para cada demonstração, pessoas usando o equipamento de coleta podem executar tarefas enquanto os seus movimentos e observações visuais são registrados. Isso pode tornar a experiência humana uma fonte de dados muito mais escalável para a inteligência artificial física, e é aí que está a aposta da LiberAI: se a experiência humana for abundante e bem medida, o custo de ensinar cada tarefa nova pode cair.
O modelo também usa o que a empresa chama de Representação Unificada de Incorporação. Em linguagem simples, isso significa que o modelo recebe informações sobre o corpo que está executando a ação, como altura, comprimento do braço, configuração do corpo e geometria da mão, ao lado da geometria e das capacidades de movimento de braços robóticos e mãos destras. A ideia é que o modelo não precise assumir que todo corpo executa uma tarefa exatamente da mesma forma. Uma pessoa alta, uma pessoa mais baixa e um robô podem abrir a mesma gaveta com movimentos um pouco diferentes, e o Liber-0 tenta aprender o comportamento físico subjacente levando essas diferenças em conta.
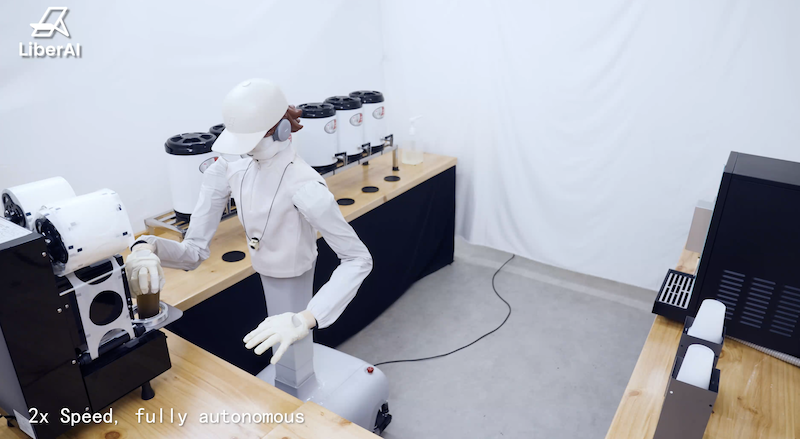
O hardware acompanha essa filosofia. O robô da LiberAI, chamado LEO, tem mãos destras, pulsos articulados e cintura ajustável, e as suas câmeras são posicionadas para oferecer visões mais alinhadas com as gravações humanas usadas no treino. A lógica é reduzir diferenças desnecessárias entre o movimento humano e o movimento do robô, para que a experiência humana seja mais fácil de transferir. Em testes descritos no material técnico da empresa, políticas treinadas com os mesmos registros de luva e quantidades iguais de dados de teleoperação para cada plataforma registraram, em três tarefas, média de 90,4 pontos para o LEO, contra 62,1 para outra plataforma, chamada Tianji. São números da empresa, em tarefas específicas, mas ilustram o peso do alinhamento entre corpo, câmeras e dados.
O teste das 60 tarefas, explicado sem exagero
A avaliação que gerou o número de 36% foi montada da seguinte forma. A LiberAI reuniu 60 tarefas de manipulação propostas pelo GPT-6, divididas em três grupos de 20: tarefas de pegar e colocar, outras tarefas de manipulação e tarefas mais desafiadoras, que não são de pegar e colocar e que exigem sequências mais longas. Cada tarefa foi testada 10 vezes, em um total de 600 tentativas. O modelo avaliado não tinha sido treinado com demonstrações de robô coletadas especificamente para aquelas tarefas. É isso que a empresa chama de generalização zero-shot em nível de tarefa: o modelo foi treinado com dados de robô no pré-treino, mas não com demonstrações de robô feitas para as tarefas avaliadas.
O resultado geral foi de 36,0% de sucesso. Por grupo, o desempenho foi bem desigual: 63,5% nas tarefas de pegar e colocar, 34,0% nas outras tarefas de manipulação e apenas 10,5% nas tarefas mais desafiadoras e de horizonte longo. Essa desigualdade é, na verdade, a informação mais útil da avaliação. Ela mostra que o modelo já lida razoavelmente com pegar e colocar, que é a tarefa mais simples e mais estruturada, mas ainda tropeça muito quando a tarefa exige vários passos, coordenação mais fina e adaptação ao longo do caminho. Para quem imagina um robô doméstico fazendo café, arrumando a casa ou cozinhando, é justamente o terceiro grupo que mais se parece com a vida real, e é nele que o Liber-0 está mais longe.
Outros testes descritos pela empresa ajudam a entender o papel dos dados de luva. Em uma avaliação com oito tarefas, uma política treinada com apenas 25% do conjunto completo de demonstrações de robô, mais 100% do conjunto de demonstrações de luva, registrou uma pontuação de progresso de 75,6, contra 72,8 de uma política treinada com 100% das demonstrações de robô. Em outro teste, quando as demonstrações de robô cobriam apenas pegar e colocar, a pontuação em outros tipos de manipulação foi de 2,2. Ao adicionar demonstrações de luva cobrindo ações que não são de pegar e colocar, a pontuação subiu para 47,5, e com dados de luva mais amplos, para 54,6, perto dos 56,3 da referência com teleoperação completa. Esses números são pontuações de progresso, não taxas de sucesso, e não significam que a quantidade total de dados caiu 75%, porque uma quantidade substancial de dados humanos foi adicionada. O que eles sugerem é que a experiência humana medida pela luva pode tornar um conjunto menor de demonstrações de robô mais útil, e pode ampliar comportamentos que as demonstrações de robô sozinhas não cobriam.
O treinamento do Liber-0, segundo a empresa, acontece em estágios. Primeiro, o modelo aprende previsão visual ampla a partir de vídeos de atividades humanas diversas. Depois, combina a previsão de observações futuras com a previsão de ações, juntando vídeo humano com informações de movimento das luvas e dos robôs. Por fim, uma etapa focada em manipulação dá mais ênfase a movimentos precisos e à interação física sustentada. A LiberAI diz que a abordagem completa de treino do Liber-0 produziu o melhor desempenho geral de manipulação entre as configurações avaliadas na sua pesquisa. É uma afirmação da empresa sobre a sua própria pesquisa, e como tal deve ser lida.
O que os 36% não provam
O primeiro limite é a origem dos números. Todos os resultados citados aqui são da LiberAI, divulgados em comunicado e material técnico da empresa, e ainda não passaram por verificação independente. Não há, até agora, um laboratório externo reproduzindo a avaliação das 60 tarefas nas mesmas condições e publicando um resultado próprio. Isso não significa que os números estejam errados, mas significa que eles são um ponto de partida, não um veredicto.
O segundo limite é o que o teste mede. As tarefas foram propostas pelo GPT-6, um modelo de linguagem, e executadas em condições de avaliação controladas, não em casas reais, com objetos reais, bagunça real e interrupções reais. Um robô que acerta 63,5% das tarefas de pegar e colocar em laboratório ainda está longe de um robô confiável para a cozinha de alguém, onde um erro pode quebrar um copo, derramar um líquido quente ou travar no meio de uma tarefa. O grupo de tarefas longas, com apenas 10,5% de sucesso, é o lembrete mais claro dessa distância.
O terceiro limite é físico, e a própria LiberAI o reconhece como trabalho futuro. As luvas atuais registram poses e trajetórias das mãos, mas contato e força continuam sendo dimensões importantes a desenvolver. Dois movimentos que parecem quase idênticos podem produzir resultados muito diferentes dependendo de onde exatamente ocorre o contato e de quanta força é aplicada. Para tarefas como inserir, apertar ou manipular materiais flexíveis e deformáveis, essa informação tátil e de força pode ser decisiva, e ainda não está no centro do modelo.
Por fim, há o limite do custo e da escala. Treinar com mais de 2,2 milhões de horas de experiência humana é impressionante como pesquisa, mas não responde, por si só, quanto custa levar esse modelo para um robô real, em uma casa real, com segurança, manutenção e preço acessível. A história da robótica está cheia de demonstrações impressionantes em laboratório que demoraram anos para virar produto, e o Liber-0, por enquanto, pertence a essa categoria: uma demonstração de pesquisa promissora, com um caminho longo até a vida cotidiana.
O que acompanhar a partir de agora
Três pontos merecem atenção. Primeiro, a reprodução independente da avaliação das 60 tarefas, que vai dizer se os 36% se sustentam fora do laboratório da LiberAI. Segundo, o desempenho em tarefas longas e em ambientes não controlados, que é onde um robô de uso geral de fato se prova. Terceiro, os próximos passos da empresa em sensores de contato e força, e na expansão da coleta de dados para ambientes do dia a dia, que podem fechar parte da lacuna entre assistir e fazer.
Enquanto isso, a leitura mais útil do Liber-0 não é a de um robô pronto, e sim a de uma mudança de método. Se a experiência humana, bem medida, conseguir ensinar robôs a tentar tarefas novas sem demonstração específica para cada uma, o custo de ensinar robôs cai, e o número de tarefas que vale a pena ensinar cresce. Os 36% de hoje, nesse sentido, importam menos como nota final e mais como ponto de partida: um modelo que já acerta mais de um terço do que nunca treinou diretamente está mostrando que o caminho de aprender com humanos pode funcionar, mesmo que ainda falte muito para ele funcionar bem.
Glossário
World Action Model: modelo que aprende relações entre o que se observa, a ação física executada e o que acontece no mundo depois da ação. Zero-shot: capacidade de tentar uma tarefa nova sem ter sido treinado com demonstrações específicas para aquela tarefa. Manipulação: no contexto da robótica, a capacidade de pegar, mover, abrir, girar e transformar objetos com as mãos ou garras do robô. Teleoperação: operação de um robô à distância por um humano, usada para coletar demonstrações de movimentos. Luva instrumentada: luva com sensores que registra poses e trajetórias das mãos durante a manipulação de objetos. Incorporação: o corpo que executa a ação, com suas medidas, articulações e limites de movimento, que afetam como uma tarefa pode ser feita. Horizonte longo: tarefa que exige uma sequência longa de passos, com adaptação ao longo do caminho, em vez de uma única ação isolada. Pré-treino: fase inicial do treinamento, em que o modelo aprende padrões amplos a partir de grandes quantidades de dados, antes de ser ajustado para tarefas específicas.
Galeria
Fontes
- LiberAI, site oficial
- LiberAI via Access Newswire, LiberAI Introduces Liber-0 for Zero-Shot Robot Manipulation
- Robotics and Automation News, LiberAI launches Liber-0 world-action model for general-purpose robots
- CRWE World, LiberAI Introduces Liber-0 for Zero-Shot Robot Manipulation
- Blerrp, LiberAI Introduces Liber-0 for Zero-Shot Robot Manipulation