 Web Designer
 Redes Sociais
 IA para Negócios
 Conteúdo Criativo
 Tecnologia da Informação
 Singles e Jingles
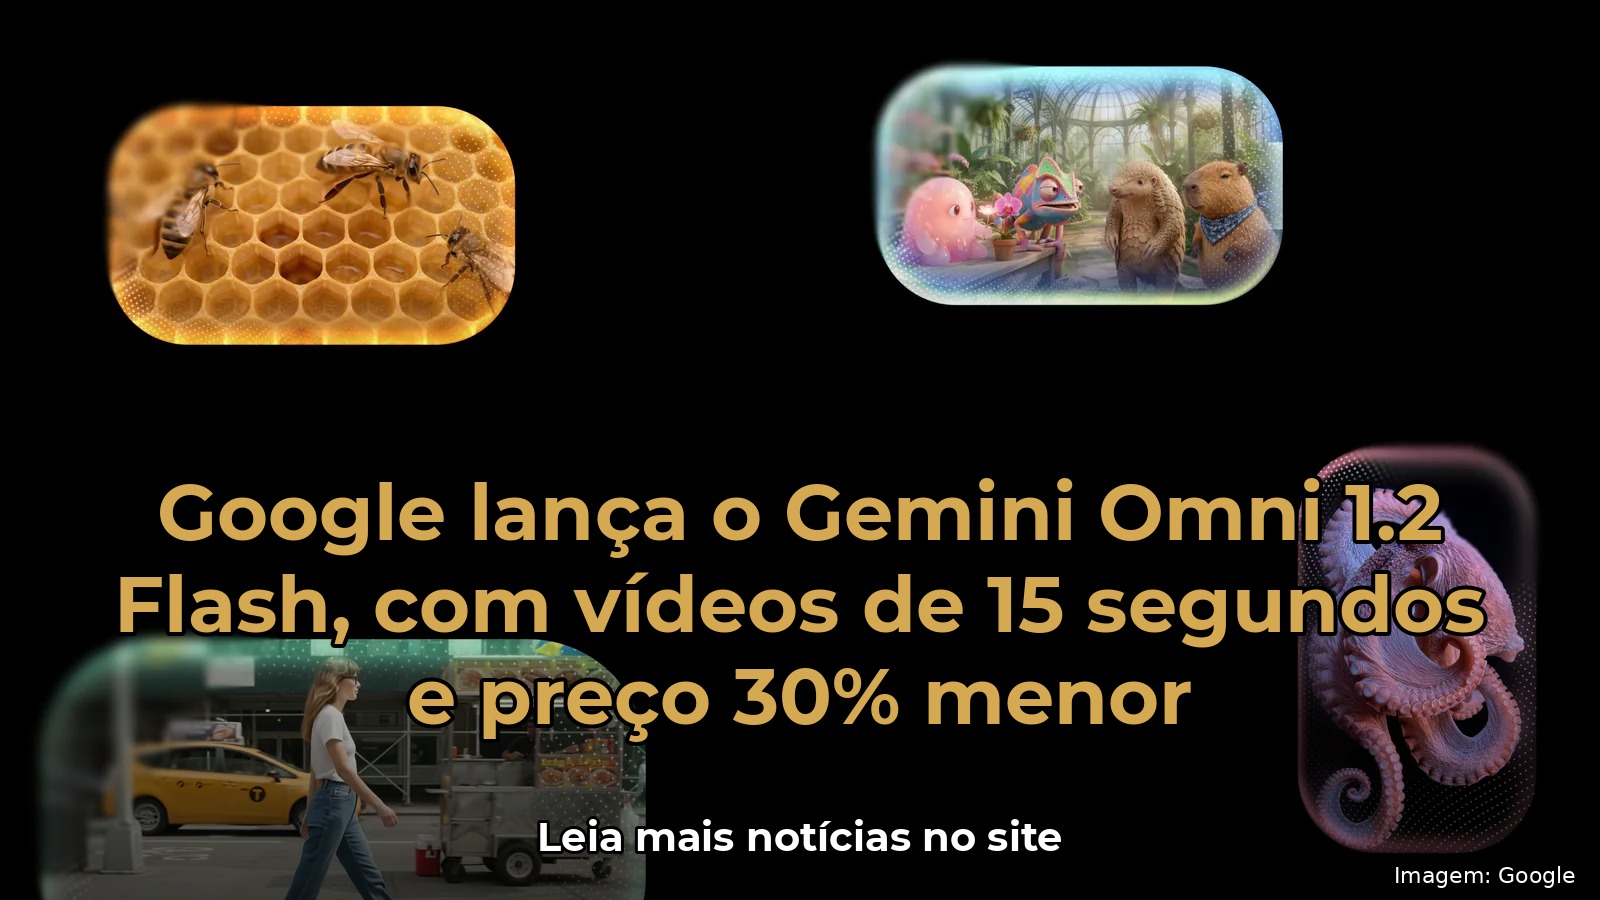
O que o Google lançou O Google lançou em 5 de novembro de 2026 o Gemini Omni 1.2 Flash, modelo de vídeo com áudio nativo da família Gemini Omni, anunciado por Anish Nangia, do Google DeepMind, no blog oficial do Google. É a primeira vez que o Gemini Omni fica geralmente disponível, ou GA, com infraestrutura do Google Cloud e com Provisioned Throughput, que é a capacidade reservada para uso em escala. Segundo o Google, o modelo é o número 1 no ranking de texto para vídeo do Artificial Analysis. O anúncio chega com três promessas juntas: vídeo mais longo, edição por conversa e preço menor, e é essa combinação que faz o lançamento pesar mais do que uma atualização comum de modelo.
Vídeo mais longo, com áudio nativo O vídeo gerado agora chega a 15 segundos, contra 10 segundos da versão anterior. A duração pode ser escolhida de 3 a 15 segundos, em incrementos de 1 segundo, o que dá controle fino sobre o tamanho do clipe. O áudio nasce junto com o vídeo, no mesmo modelo, em vez de ser colado depois, e isso vale para fala, efeitos e trilha de ambiente. O fluxo de trabalho prevê rascunho em 360p ou 720p e upscale para 1080p ou 4K, ou seja, dá para testar barato e só depois subir a resolução do corte final. Todo conteúdo criado ou editado com o Omni no app Gemini, no Google Flow ou no YouTube carrega a marca d'água digital SynthID, imperceptível, e as credenciais de conteúdo C2PA, que servem para verificar a origem do material.
Editar por conversa, sem recomeçar A edição acontece por conversa, em vários turnos, e esse é o ponto que mais muda o dia a dia de quem produz. Dá para pedir a troca do produto em cena, do fundo, da iluminação, do clima e até da proporção do vídeo sem recomeçar do zero, e o modelo mantém a consistência do que já estava bom nos turnos anteriores. Na prática, isso tira o trabalho de gerar dezenas de variações até acertar um detalhe: o ajuste vira uma frase no chat, e o vídeo volta com a mudança aplicada. O Google apresenta essa edição por turnos como uma das diferenças centrais do Omni em relação aos geradores de vídeo anteriores, que tratavam cada geração como um tiro único.
Fidelidade às referências O modelo ficou mais fiel às referências que recebe. Ele aceita referências de personagem, de produto e de estilo, além de clipes de movimento de até 3 segundos e pistas de áudio, e usa esse material para manter a identidade do que aparece na tela. Para quem faz propaganda, isso significa que o produto do cliente continua sendo o produto do cliente, e não uma versão parecida inventada pelo modelo. Para quem faz conteúdo com personagem, significa que o mesmo rosto, a mesma roupa e o mesmo cenário sobrevivem de uma cena para a outra. A fidelidade a referências é o que separa um vídeo bonito de um vídeo usável em trabalho profissional, e o Google coloca esse avanço como um dos pilares do 1.2 Flash.
Câmera cinematográfica e som mais natural A fala ficou mais natural, com sincronia labial melhor e suporte a vários falantes na mesma cena, o que abre espaço para diálogos e entrevistas geradas por IA. O controle de câmera também avançou: o modelo sustenta movimentos cinematográficos, como voos FPV contínuos, sem cortes indesejados no meio do movimento. Um voo FPV é aquele plano que atravessa o cenário como se a câmera estivesse voando por dentro dele, e manter esse movimento sem quebrar é um dos testes mais difíceis para um gerador de vídeo. Com fala natural e câmera contínua, o Omni 1.2 Flash se aproxima do tipo de plano que antes só existia com câmera real ou com animação 3D pesada.
Preço 30 por cento menor O preço caiu 30 por cento: US$ 0,07 por segundo em 720p. Para comparar, o Veo 3.1 Fast, modelo anterior de vídeo do Google, custa US$ 0,10 por segundo, segundo o Digit. Na conta direta, um vídeo de 15 segundos em 720p sai por cerca de US$ 1,05, e um vídeo de 10 segundos sai por cerca de US$ 0,70. O desconto vale para o uso por API, e o Google ainda não anunciou camada gratuita para a API do novo modelo. O preço menor, somado ao rascunho em resolução baixa, deixa o custo de experimentar bem abaixo do que era, e isso importa porque vídeo por IA é um formato que se aprende testando muito.
Onde usar O modelo está disponível na API Gemini e no AI Studio, no Flow, no Google Vids, no app Gemini e no Google Ads. No Google Vids, os clipes de 15 segundos não têm custo extra para quem tem conta Google ou Workspace. No app Gemini, o recurso está chegando para assinantes do Google AI Ultra. No Flow, a ferramenta de criação de vídeo do Google, o Omni entra no fluxo de cenas que já existia. Para empresas, a disponibilidade geral com infraestrutura do Google Cloud e Provisioned Throughput significa capacidade previsível, sem depender de fila de acesso experimental.
Limites que o próprio Google admite O Google admite que algumas coisas ainda estão em desenvolvimento: ação esportiva rápida, trocas rápidas de roteiro e física complexa. São justamente os casos em que o movimento é muito rápido ou a cena muda de repente, e o modelo ainda pode perder a coerência. As referências de áudio também seguem atrás de uma lista de acesso, a allowlist, ou seja, nem todo mundo consegue usar esse recurso de imediato. É um lembrete útil: o modelo avançou muito em duração, edição e preço, mas continua sendo uma ferramenta com limites conhecidos, e os vídeos mais exigentes ainda pedem revisão humana antes de ir ao ar.
Por que isso importa O Gemini Omni 1.2 Flash junta três coisas que raramente chegam juntas num lançamento: vídeo mais longo com áudio, edição por conversa e preço menor. Sozinho, cada avanço seria uma atualização de rotina. Juntos, eles mudam o custo de produzir vídeo com IA e o controle que o criador tem sobre o resultado. A disponibilidade geral com infraestrutura do Google Cloud tira o modelo do estágio experimental e abre a porta para uso em escala por empresas, agências e criadores. E o primeiro lugar no ranking citado pelo Google mostra que a disputa dos modelos de vídeo continua acirrada, com o Google tentando recuperar terreno com preço e com edição por conversa, e não só com qualidade de imagem.
Glossário Modelo de vídeo com áudio nativo: modelo que gera imagem em movimento e som juntos, no mesmo processo, em vez de gerar o vídeo mudo e colar o áudio depois. GA, geralmente disponível: estágio em que um produto sai do acesso limitado e passa a ser oferecido para todos, com suporte e infraestrutura de produção. Provisioned Throughput: capacidade de processamento reservada, que garante velocidade e disponibilidade previsíveis para quem usa o modelo em escala. SynthID: marca d'água digital do Google, imperceptível, que identifica conteúdo gerado por IA. Upscale: processo de aumentar a resolução de um vídeo ou imagem depois de gerado. FPV: sigla de first-person view, o plano que simula a visão de quem voa ou se move dentro da cena. Allowlist: lista de acesso que libera um recurso só para usuários aprovados. Sincronia labial: o alinhamento entre o movimento da boca na imagem e as palavras faladas no áudio.